Mac에서 로컬 LLM 최적화하기 / EP02
128GB Mac에서도 메모리가 부족할 수 있는 이유
128GB면 큰 모델도 여러 개 돌릴 수 있을까? 모델 파일 외에 KV Cache와 실행 공간, 개발 도구가 쓰는 메모리를 정리하고 상주 모델과 필요할 때 불러올 모델을 나눠봤다.
이 글의 내용
128GB면 한동안 메모리 걱정은 없겠지
Mac Studio를 주문할 때 가장 눈에 들어온 숫자는 128GB였다. 지금 쓰는 iMac은 8GB니까, 이 정도면 메모리 때문에 작업을 멈추는 일은 한동안 없지 않을까 싶었다.
EP01에서는 로컬 LLM이 느린 이유를 Prefill과 Decode로 나눠봤다. 이번에는 그보다 먼저 걸릴 수도 있는 문제다. 아예 메모리에 들어가기는 할까?
처음엔 모델 파일 크기부터 봤다. 그런데 내가 하고 싶은 건 큰 모델 하나 켜놓고 채팅하는 것만은 아니다. Hermes에 붙일 언어 모델도 두고, 필요할 때 이미지나 음성 모델도 쓰고 싶다. 그 옆에서는 앱을 만들고 시뮬레이터도 돌릴 거고.
적어놓고 보니 128GB에 맡기려는 일이 꽤 많다. 아직 Mac Studio는 배송 전이다. 이번 글은 부족했다는 사용기가 아니라, 받아서 무엇을 확인할지 정리한 메모다.
모델 파일 말고도 자리가 필요하다
디스크의 모델 파일은 주로 가중치와 그 형식에 필요한 데이터를 담는다. 실행하면 여기에 대화를 위한 KV Cache, 중간 계산 결과와 임시 작업 공간, 런타임이 잡는 메모리가 더해진다. Transformer 추론 분석 논문도 가중치와 실행 중 데이터를 구분한다.
메모리를 항목별로 나눠보면 무엇을 남겨둬야 할지 조금 더 잘 보인다. 아래 숫자는 모델을 골라 계산한 요구량이 아니라, 128GB를 배분해보는 설명용 예시다.
128GB를 나눠본다면
설명용 가상 예산 · 시나리오별 실측 비교 아님
| 항목 | GB | % |
|---|---|---|
| macOS 및 개발 도구 | 20 | 15.6 |
| 기본 LLM 가중치 등 | 28 | 21.9 |
| Vision·이미지·음성 모델 | 32 | 25.0 |
| KV Cache 및 작업 공간 | 16 | 12.5 |
| 예비 공간 | 32 | 25.0 |
| 합계 | 128 | 100 |
이 그래프는 실측 결과가 아닌 설명용 메모리 예산입니다. 실제 사용량은 모델, 컨텍스트 길이, 런타임, 동시 작업에 따라 달라집니다.
예비 공간 32GB는 예약하거나 점유한 메모리가 아니라 사용하지 않고 남겨두려는 여유 용량이다. 각 항목도 고정 요구량이 아니다. OS·가중치·KV Cache·런타임 캐시는 서로 영향을 줄 수 있어 실제 계측값을 단순히 더하면 안 된다.
어떤 작업을 하느냐에 따라
각 시나리오를 펼쳐 구성과 배분 원칙을 볼 수 있다. 위 숫자는 A·B·C의 요구량이 아니다. 모델·양자화·컨텍스트·런타임은 미확정이며 시나리오별 수치 비교는 도착 후 실측으로 남긴다.
A · 일반 운영
Hermes · 중형 General LLM · JevMLX · 개발 도구 · 소형 음성 모델
자주 쓰는 언어·판단 모델부터 상주시키고 개발 작업의 여유를 남긴다. Hermes와 도구 자체의 사용량도 확인한다.
B · 멀티모달 작업
중형 General LLM · Vision · 이미지 생성 · 음성 모델 · 개발 도구
필요한 모델을 작업 순서에 따라 불러온다. 전부 동시에 올리지 않고, 생성 중 활성화·작업 버퍼의 피크까지 확인한다.
C · 대형 LLM 실행
대형 Qwen 또는 DeepSeek 후보 · 가중치와 KV Cache · macOS·런타임 · 최소한의 다른 상주 모델
다른 모델을 줄인 뒤 전체 가중치, 컨텍스트와 실행 공간을 확인한다. MoE의 active parameters만으로 들어갈지 판단하지 않는다.
Apple Silicon의 통합메모리는 CPU와 GPU가 공유한다. MLX는 같은 배열을 CPU와 GPU에서 사용할 수 있다고 설명한다. 별도 VRAM으로 데이터를 옮길 필요가 줄어드는 장점은 있지만, macOS와 다른 앱이 쓸 공간도 이 안에 있다.
그래서 “128GB Mac이니까 128GB 모델도 되겠네”는 계산이 빠져 있다. 가중치 외의 공간과 시스템 여유가 필요하다. Metal에는 권장 working set 크기도 있다. 설치된 메모리 숫자를 GPU에 안전하게 쓸 수 있는 예산으로 그대로 옮기지는 않으려 한다.
Dense 모델과 MoE도 구분해야겠다. Dense 모델은 일반적으로 각 토큰에 대부분의 모델 가중치를 사용하지만, MoE는 일부 expert를 골라 계산한다. 그래서 MoE 논문에서는 전체 크기인 total parameters와 토큰당 계산에 참여하는 active parameters를 나눠 적는다. 활성 파라미터가 작아도 expert 가중치를 전부 상주시킨다면 메모리 예산에는 전체 가중치가 중요하다.
필요한 expert만 SSD에서 가져오는 streaming은 상주량을 줄일 수 있지만, 대신 데이터를 읽고 옮기는 I/O 비용이 생긴다. 내 Mac에서 쓸 수 있는 구현인지도 별개다. 이 방법은 EP04에서 따로 알아보려 한다.
대화가 길어지면 모델 밖의 메모리도 늘어난다
KV Cache는 앞에서 계산한 Key와 Value를 보관해 다시 쓰는 공간이다. 일반적인 full-attention 모델에서는 보관하는 토큰이 많아질수록 저장량도 늘어난다. 다만 캐시 구현에 따라 필요한 만큼 늘리거나 최대 길이를 미리 잡기도 한다.
단순한 경우의 저장량은 이렇게 생각할 수 있다.
KV 바이트 ≈ 2(K와 V) × 레이어 수 × KV head 수 × head dimension × 저장 토큰 수 × 원소 바이트 수
아래는 레이어 32개, KV head 8개, head dimension 128, 원소당 2바이트, 세션 하나를 가정한 계산이다. 특정 Qwen의 사양도, 주문한 Mac의 측정 결과도 아니다. 버퍼 여유와 메타데이터는 제외했다.
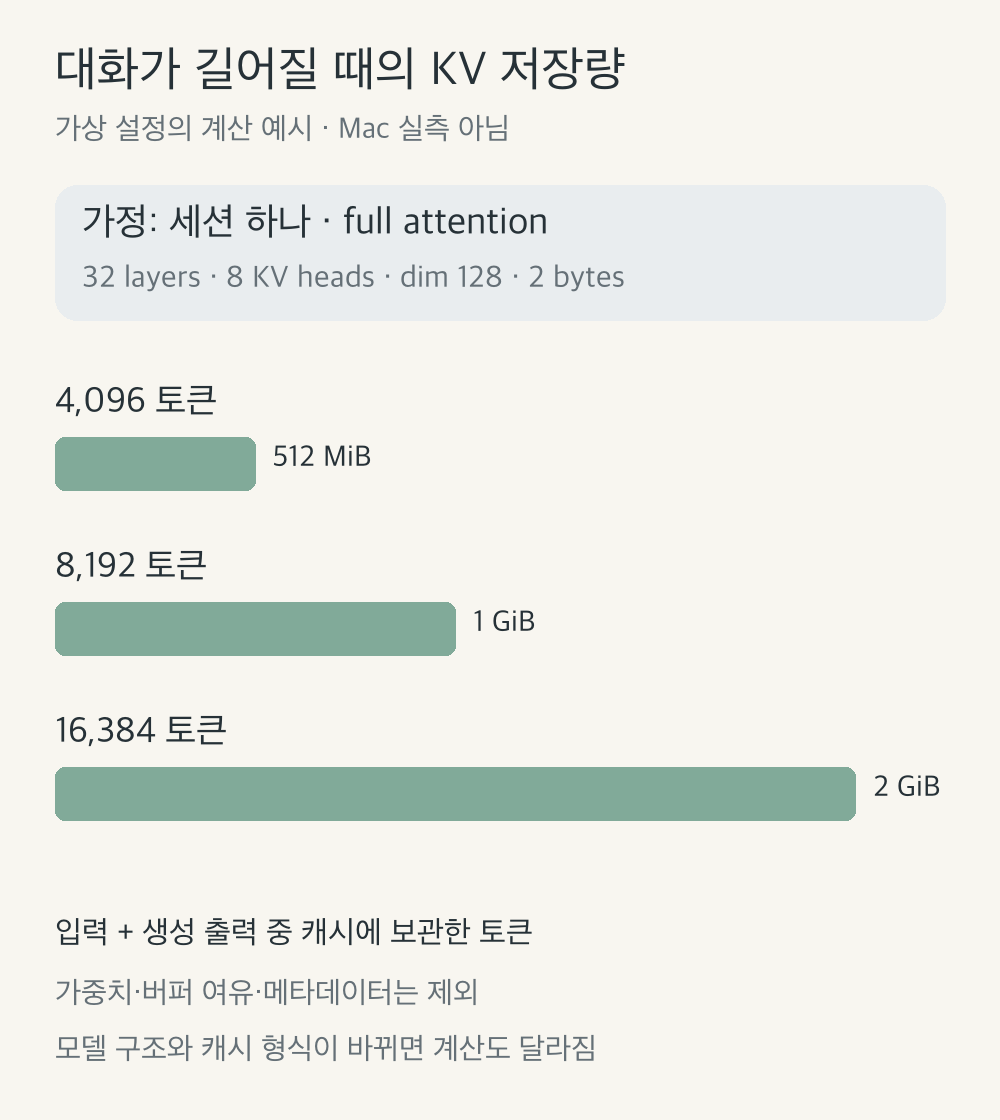
이 식을 모든 모델에 대입하면 안 된다. GQA는 여러 query head가 KV head를 공유하고, MQA는 KV head 하나를 공유한다. 다른 조건이 같다면 KV head 수가 줄수록 저장량도 줄어든다. Sliding-window 레이어는 캐시 성장이 제한될 수 있고, 하이브리드 모델은 레이어별 상태 구조부터 다를 수 있다. 모델 이름보다 실제 설정을 확인해야겠다.
가중치를 4bit로 줄였다고 KV Cache까지 자동으로 4bit가 되는 것도 아니다. 캐시 양자화 지원과 설정은 별개다. FP16은 원소당 2바이트, FP8은 1바이트지만 실제 저장에는 scale 같은 부가 데이터도 들어갈 수 있다. vLLM의 FP8 KV 문서처럼 지원되는 조합을 확인해야 하고, 이 기능이 Mac 런타임에서도 그대로 된다는 뜻은 아니다. 결국 모델 다운로드 페이지의 용량만 보고 긴 대화까지 가능하다고 판단하기는 어렵다.
모델 두 개와 대화 두 개는 다른 문제다
같은 모델로 대화를 둘 돌린다고 가중치까지 항상 두 벌 필요한 건 아니다. llama.cpp 서버처럼 한 엔진이 여러 요청을 처리할 수도 있다. 그래도 세션마다 유지할 상태와 캐시 공간은 살펴봐야 한다. 공통 대화 앞부분을 공유하는지, 캐시를 어떻게 할당하는지도 구현에 달려 있다.
반대로 같은 모델을 별도 프로세스로 각각 올리면 한 엔진의 공유를 그대로 기대할 수 없다. 모델 두 개를 함께 띄우는 경우엔 각 모델의 가중치와 실행 공간까지 확인해야 하고.
| 늘리는 것 | 추가로 확인할 메모리 |
|---|---|
| 같은 대화의 길이 | KV Cache 등 대화 상태 |
| 동시에 처리할 세션 수 | 세션별 상태, 배치 작업 공간, 공유 여부 |
| 서로 다른 모델 수 | 모델별 가중치·캐시·실행 공간 |
| 개발 도구와 시뮬레이터 | 시스템 전체 여유와 메모리 압박 |
Hermes가 긴 대화에 도구 실행 결과까지 가져오는 상황도 궁금하다. 사람이 보낸 짧은 질문 하나만으로 입력 길이를 짐작하면 안 될 것 같다. 실제로 모델에 넘어간 토큰 수를 남겨봐야겠다.
모든 모델을 계속 켜둘 필요가 있을까
지금은 중형 General LLM과 JevMLX 같은 소형 판단 모델을 자주 쓰는 쪽으로 생각하고 있다. STT나 임베딩 모델은 필요에 따라 추가하고. Qwen3.8 Flash Next 등 대형 LLM 후보와 이미지·영상·음악 생성 모델은 필요할 때 불러오는 쪽이다. 후보 이름과 실제 버전, 메모리 요구량은 아직 확인·확정 전이다. 전부 동시에 올릴 계획은 아니다.
특히 이미지·영상 생성은 가중치가 들어간다고 끝이 아니다. 추론 중 활성화와 작업 버퍼가 커질 수 있고, 해상도나 프레임 수 등 작업 조건도 피크에 영향을 준다. Diffusers의 메모리 문서를 참고하되 실제 사용할 런타임에서 확인해보려 한다. 큰 작업 전에 다른 모델을 잠깐 내려야 할지도 모르겠다.
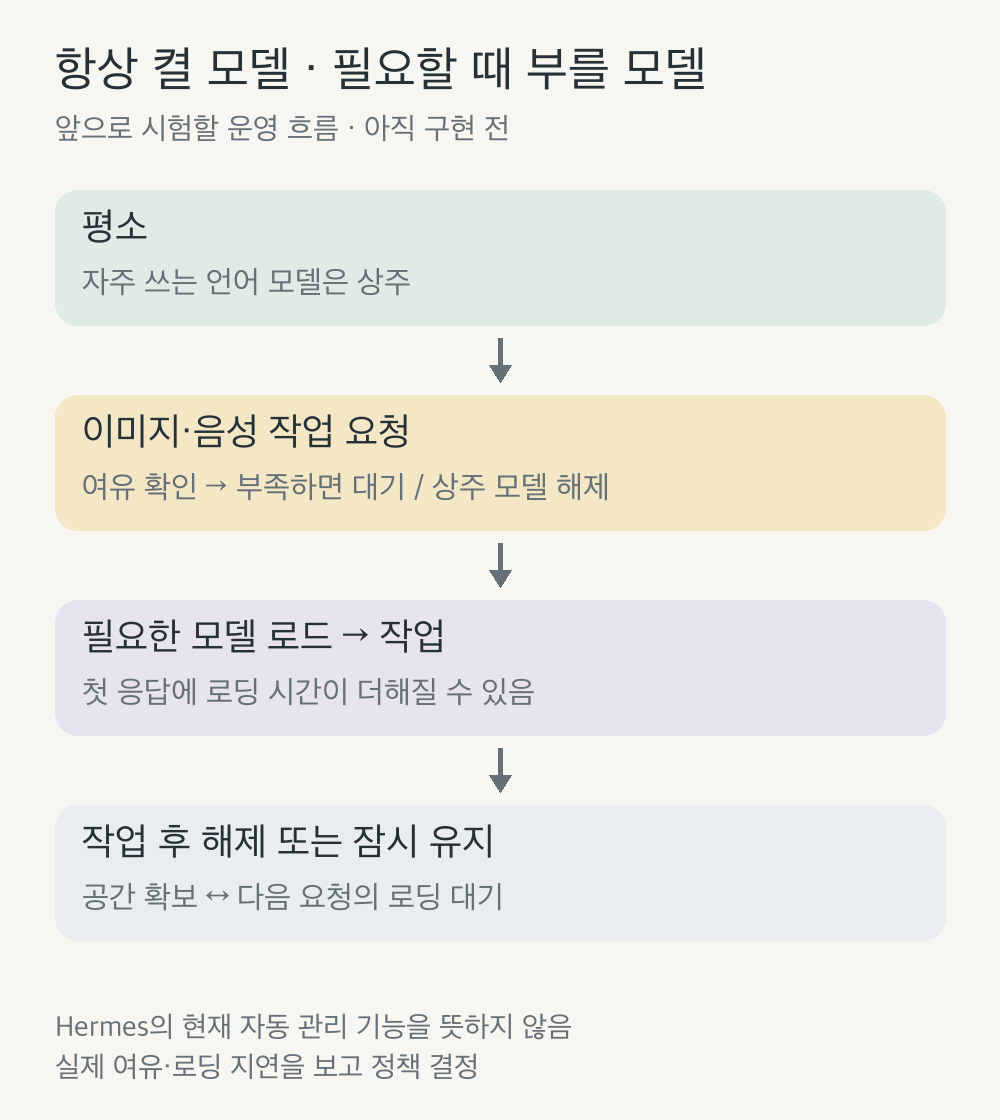
공간을 아끼는 대신 첫 요청은 모델 로딩을 기다려야 한다. 한 번 불러온 모델을 바로 내릴지, 잠깐 남겨둘지도 사용 빈도와 로딩 시간에 달렸다. SSD에 파일이 있다는 것과 메모리에 실행 준비가 된 상태는 다르니까.
이 부분은 아직 구현한 기능이 아니라 운영 계획이다. “몇 개까지 켤 수 있나”만큼 “다시 부르는 데 얼마나 걸리나”도 기록하려 한다.
메모리 숫자는 더하기 전에 이름부터 보기
실험할 때는 활동 모니터와 런타임 지표를 함께 볼 생각이다. Apple의 설명에 따르면 메모리 압박은 남은 공간뿐 아니라 swap 속도, wired memory, 파일 캐시 등의 영향을 받는다. 메모리가 얼마나 찼는지만 보는 대신, 대화가 길어질 때 메모리 압박과 swap이 어떻게 변하고 응답은 얼마나 느려지는지 함께 살펴보려고 한다.
MLX에는 현재 활성 메모리, 피크 메모리, allocator cache를 보는 API가 있다. 여기서 allocator cache는 다음 할당에 재사용하려 남겨둔 공간이지, 대화의 KV Cache가 아니다.
프로세스 메모리와 MLX 수치를 단순히 더하면 같은 공간을 중복해서 셀 수도 있다. MLX 피크를 시스템 전체 통합메모리 피크라고 부르지도 않으려 한다. 모델을 해제한 뒤 OS 파일 캐시가 남은 상황도 따로 구분해야겠다.
도착하면 하나씩 늘려볼 생각이다
처음부터 여러 모델과 시뮬레이터를 한꺼번에 켜면 뭐 때문에 달라졌는지 알기 어렵다. 모델·양자화·런타임 버전을 고정한 뒤 순서대로 바꿔보려 한다.
| 순서 | 바꿀 조건 | 같이 기록할 것 |
|---|---|---|
| 1 | 한 모델에서 입력 길이 | 실제 토큰 수, KV 설정, 메모리·응답 변화 |
| 2 | 같은 모델의 동시 세션 수 | 세션별 길이, 배치 설정, 지연과 공유 여부 |
| 3 | 두 번째 모델 추가 | 로딩 시간, 동시 실행 여부, 피크와 해제 후 상태 |
| 4 | 개발 도구·시뮬레이터 추가 | 작업 없는 때와 평소 작업 중의 차이 |
각 단계에서 로딩부터 첫 답변, 생성, 유휴, 해제까지 남겨보고 싶다. EP01에서 나눈 TTFT·Prefill·Decode와 함께 메모리 압박, 압축, swap 변화도 보려고 한다. 일부러 한계까지 밀기보다는 평소 앱 개발을 같이 할 수 있는 여유가 어디까지인지가 더 궁금하다.
아직 모르는 것
128GB에서 어떤 모델을 얼마나 여유롭게 쓸 수 있을지, 이미지·음성 모델까지 같이 켰을 때는 어떨지 아직 모른다. 위 계산은 계산이고, 도식은 계획이다. 실제 사용량과 속도는 장비를 받아서 확인해야 한다.
처음엔 가장 큰 모델을 올려보는 게 목표였는데, 이제는 평소 쓰는 모델을 켜둔 채 앱 개발까지 편하게 할 수 있으면 좋겠다는 생각이 든다. 큰 모델은 필요할 때만 꺼내 쓰고.
그리고 메모리에 잘 들어가도 답이 느리면 또 다른 고민이 시작된다. 다음 EP03에서는 Speculative Decoding과 MTP가 그 기다림을 어떻게 줄이려는지 알아보려고 한다.