Mac에서 로컬 LLM 최적화하기 / EP03
Speculative Decoding과 MTP는 어떻게 속도를 높일까?
초안 토큰을 한꺼번에 검증하면 언제 빨라질까? Speculative Decoding과 MTP의 차이, 채택률과 추가 비용, Mac 엔진의 지원 조건을 살펴본다.
이 글의 내용
들어갔는데도 느리면
EP02에서는 128GB를 어떻게 나눠 쓸지 생각해봤다. 그런데 모델이 메모리에 들어가는 것과 답을 빨리 받는 건 또 다른 문제다.
EP01에서 본 Decode는 앞에서 만든 토큰에 이어 다음 토큰을 고르는 과정이었다. 큰 모델을 켜놓고 한 토큰씩 기다려야 한다면, 이 기다림을 줄일 방법도 있을까?
찾아보다 보니 작은 모델이 먼저 몇 토큰을 써보고, 큰 모델이 확인하는 방법이 있었다. 이름은 Speculative Decoding. 모델을 하나 더 쓰는데 오히려 빨라질 수 있다니, 처음엔 조금 이상하게 느껴진다.
아직 Mac Studio는 도착 전이다. 이번에도 실행해본 후기가 아니라, 무엇을 켜서 무엇과 비교할지 정리하는 글이다.
작은 모델이 제안하고 큰 모델이 확인한다
Speculative Decoding 논문의 기본 아이디어는 이렇다. 가벼운 draft model이 후보 토큰을 먼저 만들고, 실제 답변을 맡는 target model이 여러 위치를 묶어 평가한다. 후보가 이미 주어져 있으니 target은 각 위치에서 앞쪽 후보만 보도록 causal mask를 적용해 한 번의 검증 계산으로 확인할 수 있다.
작은 모델이 쓰는 초안 자체는 토큰을 하나씩 생성할 수도 있다. 모든 미래 토큰을 아무 의존성 없이 한꺼번에 만드는 건 아니다. 비용이 큰 target을 매 토큰마다 따로 호출하는 횟수를 줄이는 쪽에 가깝다.
문장으로 보는 제안 → 검증 → 이어가기
Greedy 검증을 단순화한 가상 예시
입력 · 오늘 날씨가
Draft · 후보를 제안하는 모델
- 1정말후보
- 2좋아서후보
- 3산책을후보
- 4갔다후보
Target · 검증하고 확정하는 모델
- 1정말채택
- 2좋아서채택
- 3산책을거절
- 4갔다폐기
남긴 앞부분 · 정말 → 좋아서 → 밖에서… (Target의 다음 토큰도 가상 예시)
- Draft 후보 생성
- Target 검증: 세 번째 후보에서 거절
- 앞부분 두 후보 채택
- 거절 뒤의 후보도 폐기
- 거절된 위치부터 Target 토큰으로 이어가기
산책을은 거절, 갔다는 앞 후보가 거절되어 폐기한다. 폐기는 그 토큰 자체를 Target이 검증해 틀렸다고 판단했다는 뜻이 아니다.
이 예시는 이해를 돕기 위해 단어를 토큰처럼 표현한 것으로, 실제 토크나이저의 분할 결과나 모델 실행 결과가 아닙니다.
Sampling 방식은 확률적 수락·거절과 보정 분포를 사용할 수 있다. 이 Greedy 예시를 최빈 토큰의 일치 비교만으로 일반화하지 않는다.
기존 도식과 설명 보기
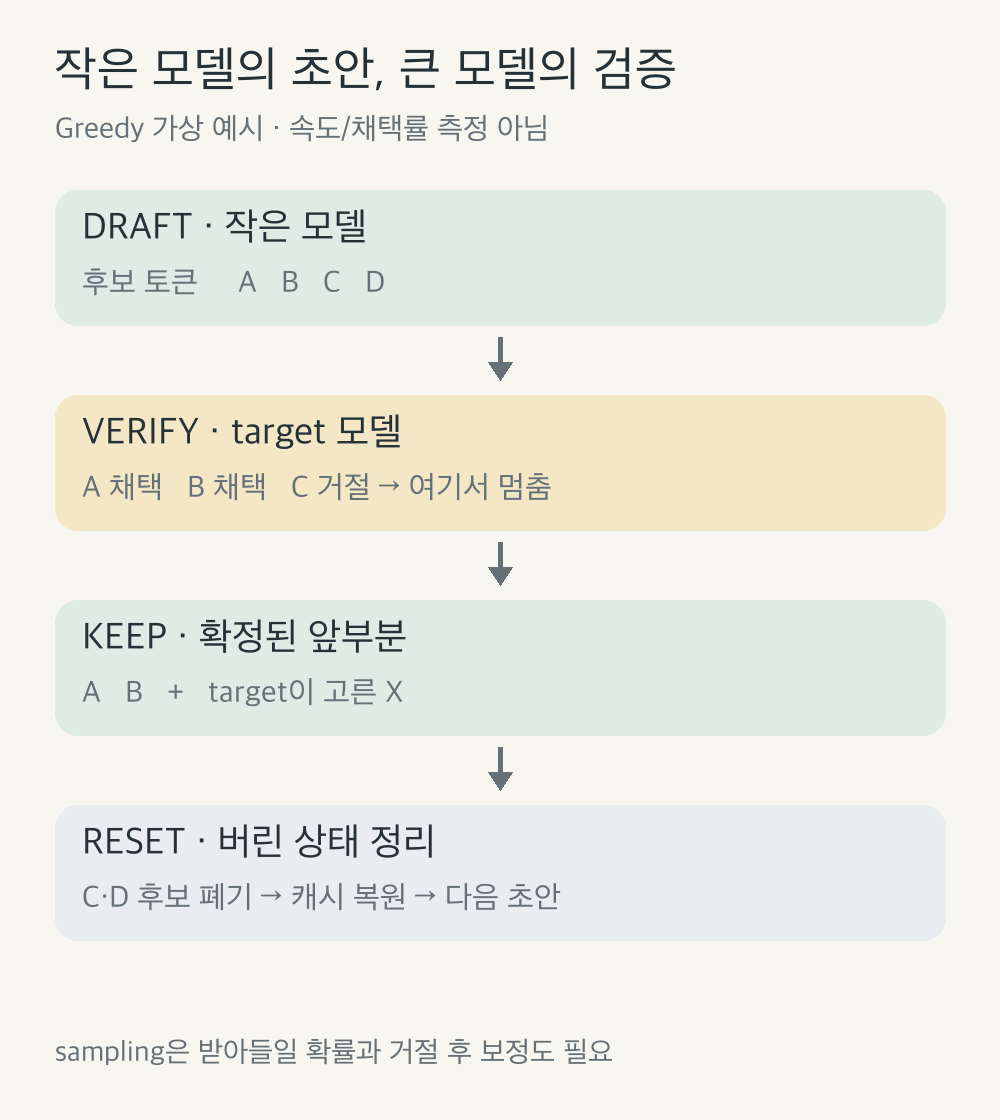
문장 예시에서는 정말과 좋아서까지 채택하고 산책을에서 멈춘다. 뒤의 갔다도 거절된 앞부분을 전제로 만든 후보라 그대로 이어 붙일 수 없다. 거절 지점에서 target이 고른 토큰으로 이어가고, 캐시에서 버린 후보의 상태도 되돌려야 한다.
확률을 두고 뽑는 sampling에서는 이 그림처럼 토큰이 같은지만 비교해서 끝내면 안 된다. 원 논문의 분포를 보존하는 방식은 후보를 받아들일 확률과 거절 후의 보정 분포까지 계산한다. 그 조건까지 지켜야 target만 돌렸을 때와 같은 출력 분포를 말할 수 있다.
채택률이 높으면 무조건 이득일까
여기서 보고 싶은 숫자는 acceptance rate, 제안한 후보 중 실제로 받아들인 비율이다. 하지만 이것만 보고 빠르다고 결론 내리기는 어렵겠다.
초안을 만드는 시간, 여러 후보를 검증하는 시간, 거절된 캐시를 되돌리는 비용이 먼저 든다. 작은 모델의 가중치와 캐시도 메모리를 쓴다. 후보를 길게 만들수록 검증할 양도 늘고, 앞쪽에서 거절되면 뒤쪽 초안은 버리게 된다. 이런 비용과 채택 길이는 llama.cpp의 speculative 설정을 고를 때도 함께 확인할 부분이다.
같은 출력 4개, 가상 시간 비교
아래 비교는 앞의 거절 예시와 다르다. 여기서는 후보 4개가 모두 채택됐다고 가정한다.
- 일반 Decode
- 4 × 100ms = 400ms
- Speculative
- Draft 40ms + 검증 140ms = 180ms
- 가상 시간 비율
- 400 / 180 ≈ 2.22× · 220ms 단축
실제 벤치마크 결과가 아닌 설명용 가상 수치입니다. 채택률, Draft 모델 비용, 검증 비용, 하드웨어 및 런타임에 따라 성능은 달라집니다.
출력 길이를 4개로 제한해 비교했다. 구현에 따라 검증 뒤에 나오는 추가 토큰은 집계에서 제외하며, 별도 동기화·상태 관리 비용은 가상 두 구간에 포함됐다고 가정한다. 모든 구현의 정확한 실행 절차나 TTFT를 표현하는 그림은 아니다.
기존 도식과 설명 보기
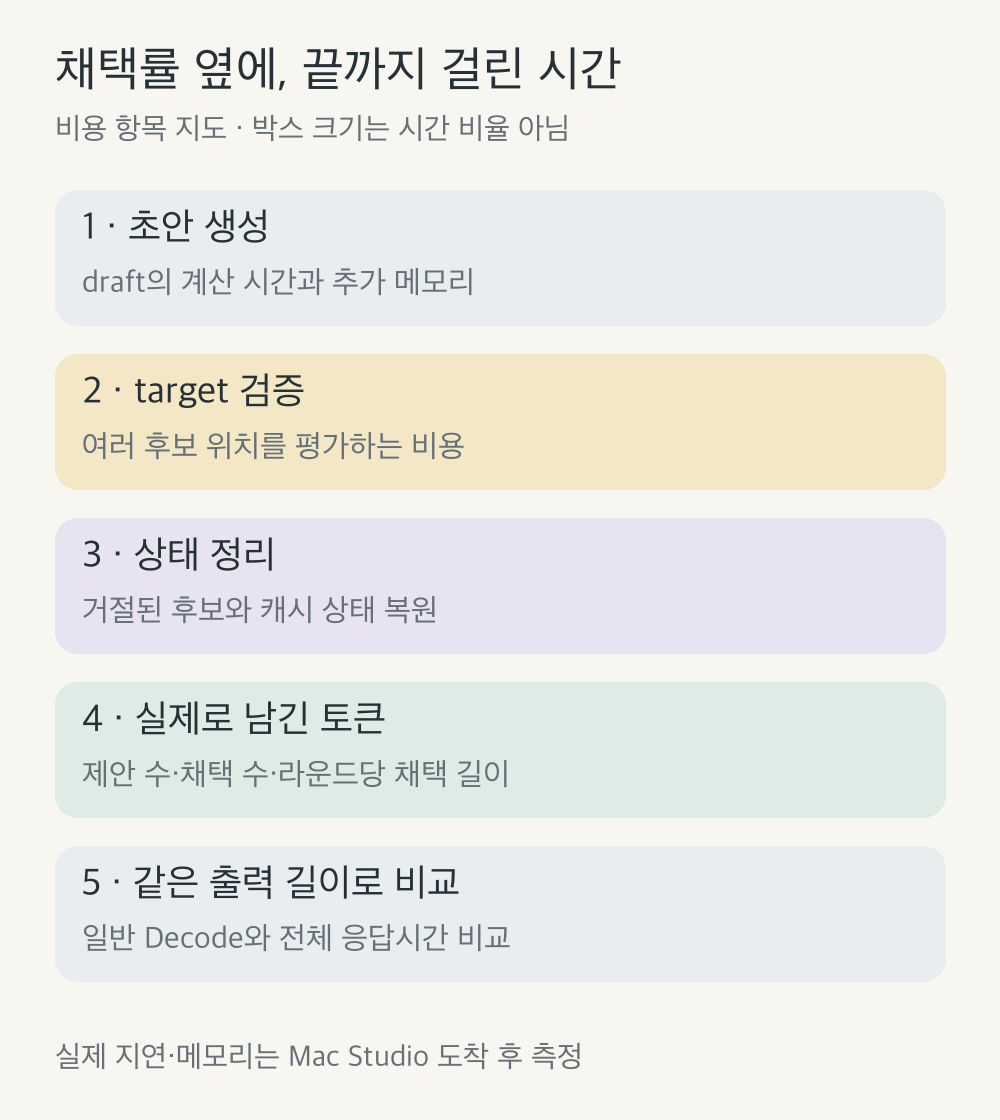
일반 Decode는 target이 다음 토큰을 매번 생성한다. 반면 후보가 주어지면 target은 여러 위치를 병렬로 검증할 수 있다. 충분한 후보를 적은 비용으로 확정한다면 비싼 target의 순차 실행 횟수가 줄어드는 셈이다. 위 시간 비교는 이 가능성을 보여주려는 가정이고, 내 Mac에서 얻은 결과는 아니다.
숫자를 볼 때도 무엇을 세었는지 나눠두려고 한다.
| 지표 | 여기서 구분할 의미 |
|---|---|
| Acceptance rate | 제안한 후보 중 채택된 비율. 집계 범위도 함께 기록 |
| 평균 채택 길이 | 검증 라운드당 채택된 draft 후보 수의 평균 |
| 라운드당 확정 토큰 수 | 채택 후보에 보정·추가 토큰까지 포함한 실제 출력 수. 출력 제한·EOS 처리 명시 |
| 전체 응답 지연 시간 | 입력 처리부터 답변 완료까지. draft·검증·동기화 대기도 포함 |
| Decode throughput | 정의한 Decode 구간의 경과시간당 확정 출력 토큰 수. Prefill 포함 여부 구분 |
target이 이미 작고 빠르거나, 초안이 자주 거절되는 작업이라면 모델 하나 더 돌리는 비용을 못 건질 수도 있다. 이건 내 장비에서 확인할 가설이다. “채택률이 올랐다”와 “내가 덜 기다렸다”를 따로 기록하려고 한다.
MTP는 같은 기능의 다른 이름일까
MTP는 Multi-Token Prediction, 여러 미래 토큰을 예측하도록 학습하는 방식이다. MTP 논문은 공유된 모델 본체 위에 여러 예측 head를 두는 구조를 설명한다. 반면 speculative decoding은 후보를 만들고 검증해 생성 비용을 줄이는 실행 절차다. MTP로 만든 후보를 그 절차에 활용할 수 있다.
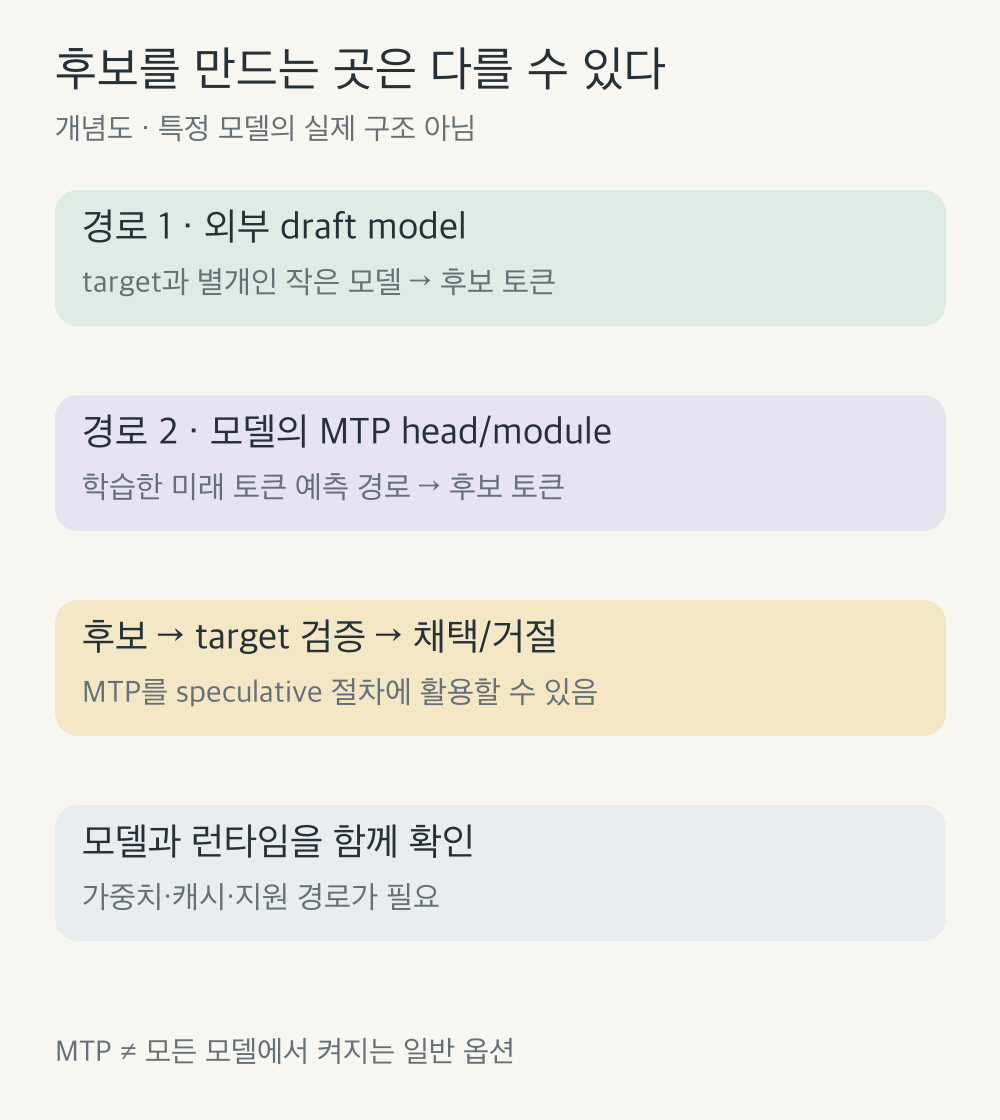
DeepSeek-V3 자료는 본체 가중치와 MTP module 가중치를 구분한다. 별도의 범용 소형 모델을 하나 더 올리는 것과는 구조가 다르다. 그렇다고 MTP라는 이름만 보고 추가 메모리가 없다거나, 어떤 엔진에서도 바로 켤 수 있다고 생각하면 안 되겠다. 학습에 사용한 기능이 실제 배포 가중치에 포함됐는지, 런타임이 추론에서 활용하는지까지 확인해야 한다.
그리고 JevMLX 같은 소형 판단 모델을 상주시킬 계획과도 별개다. 작업을 어디로 보낼지 고르는 모델이 자동으로 큰 LLM의 다음 토큰을 잘 제안하는 draft model이 되는 건 아니다.
“같은 출력”도 구분해서 보기
Greedy는 가장 높은 점수의 토큰을 고르는 방식이고, sampling은 설정한 확률로 토큰을 뽑는다. Greedy 결과가 같은지, sampling 분포를 보존하는지, 같은 seed로 글자까지 똑같이 나오는지는 서로 다른 확인이다. 수치 정밀도와 구현 차이도 살펴봐야 한다.
실제 엔진에는 이 구분이 드러난다. 확인한 ds4 문서는 nonzero temperature의 기본 모드를 opportunistic sampling으로 설명하고, target 분포 보존을 위한 --mtp-exact-sampling을 따로 둔다. 빠른 기본 설정과 exact 설정을 섞어서 비교하면 어떤 조건의 속도인지 애매해진다.
나는 우선 같은 target에서 기능을 끈 경우와 켠 경우를 비교하려 한다. 분포 보존 모드와 heuristic 모드는 결과를 나눠 적고. 예문 몇 개가 비슷하다고 sampling 분포까지 검증했다고 쓰지는 않을 생각이다.
Mac에서는 어디부터 확인할까
작은 배치의 Decode에서는 큰 모델의 가중치를 반복해서 읽는 메모리 대역폭 비용이 중요해질 수 있다. 추론의 연산·대역폭 분석을 보고 나니, 검증 한 번으로 여러 토큰을 확정하면 이 비용을 나눌 가능성이 궁금해졌다. 다만 모델 구조와 커널에 따라 효과는 달라진다. 한 라운드에서 몇 개를 확정했는지와 실제 시간을 함께 봐야겠다.
별도 draft를 올리면 가중치와 KV Cache가 추가된다. MTP도 모듈과 실행 버퍼를 쓸 수 있다. 128GB Mac Studio라 해도 속도만 보고 켜둘 수는 없겠다. EP02에서 나눠본 메모리 예산 안에 두 경로가 함께 들어가는지 확인하려 한다.
MLX는 Apple Silicon용 배열 프레임워크이고, 아래 MLX-LM은 그 위에서 LLM을 실행하는 도구다. Metal·MLX 경로에서는 draft와 검증의 GPU 실행·동기화 비용도 살펴볼 생각이다. MLX의 synchronize는 스트림 작업 완료를 기다린다. GPU 작업을 제출한 시간만 재면 완료까지 걸린 시간을 놓칠 수 있어, 런타임의 계측 경계를 먼저 확인하려 한다.
문서와 코드를 확인한 날짜는 2026년 10월 9일이다. 아래는 설치 성공 목록이 아니라 후보별로 더 확인할 항목이다. 링크는 확인한 버전에 고정했다.
| 후보 | 확인한 경로 | 실행 전에 남은 확인 |
|---|---|---|
| MLX-LM | 외부 draft model을 받는 생성 함수 | 같은 tokenizer, 되돌릴 수 있는 prompt cache, 선택한 모델·sampling 조합 |
| llama.cpp | 외부 draft와 draft-mtp 등 구분된 전략 |
GGUF의 MTP 가중치·모델 구조, Metal 경로와 캐시 복원 지원 |
| ds4 | 모델별 speculation·sampling 설정 | 선택한 모델의 Metal 실행과 exact 모드, 다른 기능과의 조합 |
| oMLX | mlx-vlm에 위임하는 VLM MTP 경로; Gemma 4 assistant·Qwen 3.5 계열 drafter 타입 확인 | 해당 모델·의존성 버전·sampling 조합의 실제 실행은 미확인 |
| Slipstream | Metal MTP 선택 커널만 확인 | host의 제안·검증·캐시 복원·sampling 전체 경로 지원은 미확인 |
파일이나 옵션이 존재한다는 것과 내가 고른 모델에서 안정적으로 실행된다는 것은 다르다. 위 코드 확인만으로 정식 지원이나 내 Mac의 성능을 보장하지는 않는다.
도착하면 기능 하나씩 켜볼 생각이다
주문한 Mac Studio M5 Max / 128GB 통합메모리 / 1TB SSD에서 먼저 target 하나로 기준을 잡고, 지원되는 draft model이나 MTP 경로를 하나만 추가해보려 한다. target 가중치·양자화·입력·컨텍스트·출력 제한·batch size·sampling 정책을 고정하고, warm-up과 프롬프트 캐시 재사용 여부도 구분한다. 엔진·커널 버전과 draft 설정은 함께 남기고.
| 기록할 것 | 확인하려는 것 |
|---|---|
| TTFT·Prefill·Decode·전체 응답시간 | 생성 중 이득이 첫 답변 대기까지 줄이는지 |
| 제안·채택 토큰 수와 라운드당 채택 길이 | 채택률 계산 방식과 버린 초안의 양 |
| draft·검증·캐시 복원 시간 | 계측 가능한 범위에서 추가 비용 분리 |
| 피크 메모리·메모리 압박·swap | 두 번째 모델이나 MTP 경로의 여유 공간 |
| 출력 유효성·작업 정답 | JSON 형식이나 고정된 과제의 결과가 유지되는지 |
| 항목 | 기본 Decode | Speculative Decode |
|---|---|---|
| TTFT | 실측 예정 | 실측 예정 |
| Decode tok/s | 실측 예정 | 실측 예정 |
| 전체 응답 시간 | 실측 예정 | 실측 예정 |
| Peak Memory | 실측 예정 | 실측 예정 |
| 평균 채택 길이 | 해당 없음 | 실측 예정 |
| 검증 라운드 수 | 해당 없음 | 실측 예정 |
| Draft 비용 | 해당 없음 | 실측 예정 |
짧은 응답과 긴 응답을 따로 비교할 생각이다. 같은 출력 제한만으로 길이가 같아지는 것은 아니니 실제 출력 토큰 수를 맞춘 비교와 자연 종료한 응답을 구분하겠다. 런타임 버전도 고정하고, 같은 sampling·컨텍스트·warm-up 조건을 구현하지 못하면 차이를 그대로 적을 거다. 위 항목은 모두 도착 후의 측정 계획이다.
같은 입력 목록을 반복해 중앙값과 편차도 보고 싶다. 답이 짧아져 빨라 보이지 않도록 실제 생성 토큰 수도 남긴다. 엔진이 내부 시간을 제공하지 않으면 전체 지연을 기록하고, 세부 시간을 측정한 것처럼 나누지는 않을 거다.
아직 모르는 것
어떤 target과 draft 조합이 잘 맞을지, MTP를 켰을 때 얼마나 빨라질지 아직 모른다. 특히 개발 도구와 Hermes를 함께 쓰는 평소 환경에서 추가 모델을 올릴 여유가 있는지도 확인 전이다.
지금까지 읽은 자료만 보면 큰 모델의 일을 줄이려면 작은 모델의 일이 먼저 늘어난다. 그 추가 작업이 나에게 이득인지가 궁금하다. 무조건 켜두기보다, 켠 날과 끈 날의 기다림부터 비교해보고 싶다.
그런데 속도 말고 남은 문제가 하나 더 있다. 정말 큰 MoE 모델의 가중치는 어디에 둘까? 다음 EP04에서는 필요한 expert를 SSD에서 불러오는 방법과 그때 생기는 I/O 비용을 알아보려 한다.
댓글과 좋아요
로그인 없이 닉네임으로 남길 수 있어. 닉네임과 댓글은 공개되고, 댓글은 확인 후 올라가.