Mac에서 로컬 LLM 최적화하기 / EP04
SSD Expert Streaming — 거대한 MoE 모델을 작은 메모리에서 실행하는 방법
큰 MoE 모델의 expert를 필요할 때만 SSD에서 읽으면 어떨까? 캐시와 미리 읽기, 남는 메모리, Apple Silicon 구현의 지원 범위를 알아봤다.
이 글의 내용
128GB보다 큰 모델은 어디에 둘까
EP02에서는 모델 말고도 메모리를 쓸 곳이 많다는 걸 정리했다. EP03에서는 들어간 모델을 조금 더 빨리 돌릴 방법을 알아봤고.
이번에는 순서가 반대다. 애초에 메모리에 다 들어가지 않는 모델은 어떻게 할까?
주문한 Mac Studio는 128GB 통합메모리, SSD는 1TB다. 큰 모델 하나가 그 메모리를 거의 다 쓰면 개발 도구나 다른 AI 모델을 함께 켜기 어려워진다. 그렇다고 더 큰 모델을 볼 때마다 장비를 바꿀 수도 없고. 필요한 부분만 SSD에서 가져오는 방법이 눈에 들어왔다.
SSD Expert Streaming. 이름은 그럴듯한데, 결국 답을 만드는 동안 디스크를 기다려야 한다는 얘기이기도 하다. 아직 장비는 도착 전. 이번 글은 직접 돌린 후기가 아니라, 어디에 메모리를 쓰고 어디서 기다릴지 알아본 기록이다.
MoE는 일부만 쓰지만, 나머지가 없어지는 건 아니다
Dense 모델과 달리 MoE의 일부 레이어에는 여러 expert가 있다. Router가 입력에 따라 그중 일부를 골라 계산에 참여시킨다. Switch Transformers는 이런 선택적 실행을 다루는 대표적인 연구다. 모델에 따라 항상 쓰는 shared expert나 다른 공통 가중치도 있다.
그래서 total parameters와 active parameters를 나눠 봐야 한다. 앞쪽은 모델 전체의 규모, 뒤쪽은 특정 토큰을 처리할 때 활성화되는 범위다. Active가 작다고 저장할 전체 expert 가중치까지 작아지는 건 아니다.
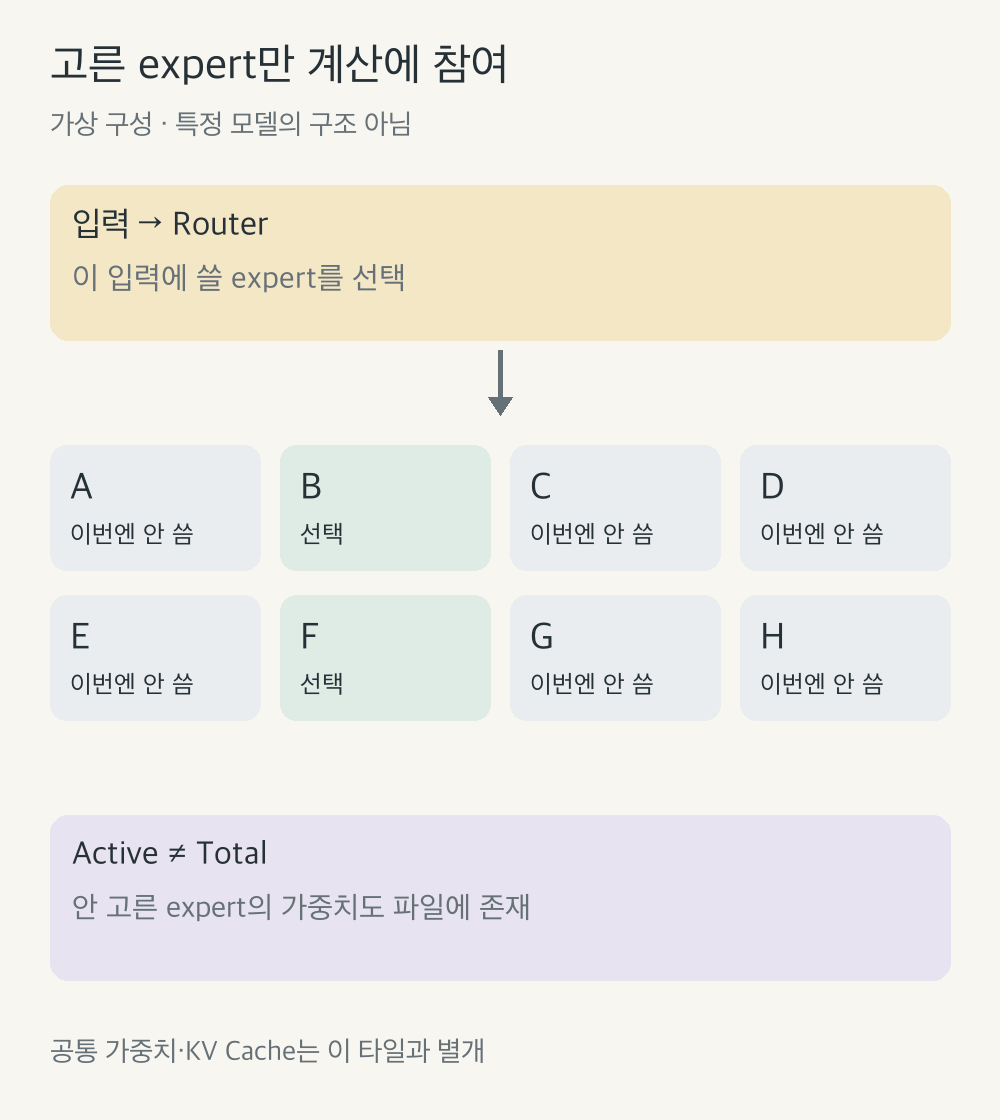
이때 선택하지 않은 expert까지 항상 메모리에 올려두는 대신, SSD에 두고 필요해질 때 읽을 수 있다. SSD에서 계산하는 건 아니다. 읽어온 가중치를 메모리의 실행 버퍼에 놓고 CPU·GPU가 계산한다.
LLM in a flash도 제한된 메모리에서 flash의 가중치를 공급하는 문제를 다룬다. 다만 그 논문의 기법과 모든 MoE 엔진의 expert streaming이 같은 구현이라는 뜻은 아니다.
이미 있으면 쓰고, 없으면 읽는다
흐름만 보면 간단하다. Router가 expert를 고르고, 사용할 가중치가 메모리에 있는지 확인한다. 있으면 cache hit. 없으면 cache miss라 SSD에서 가져와야 한다. 캐시를 직접 관리하는 엔진이라면 예산이 찼을 때 무엇을 내보낼지도 정한다.
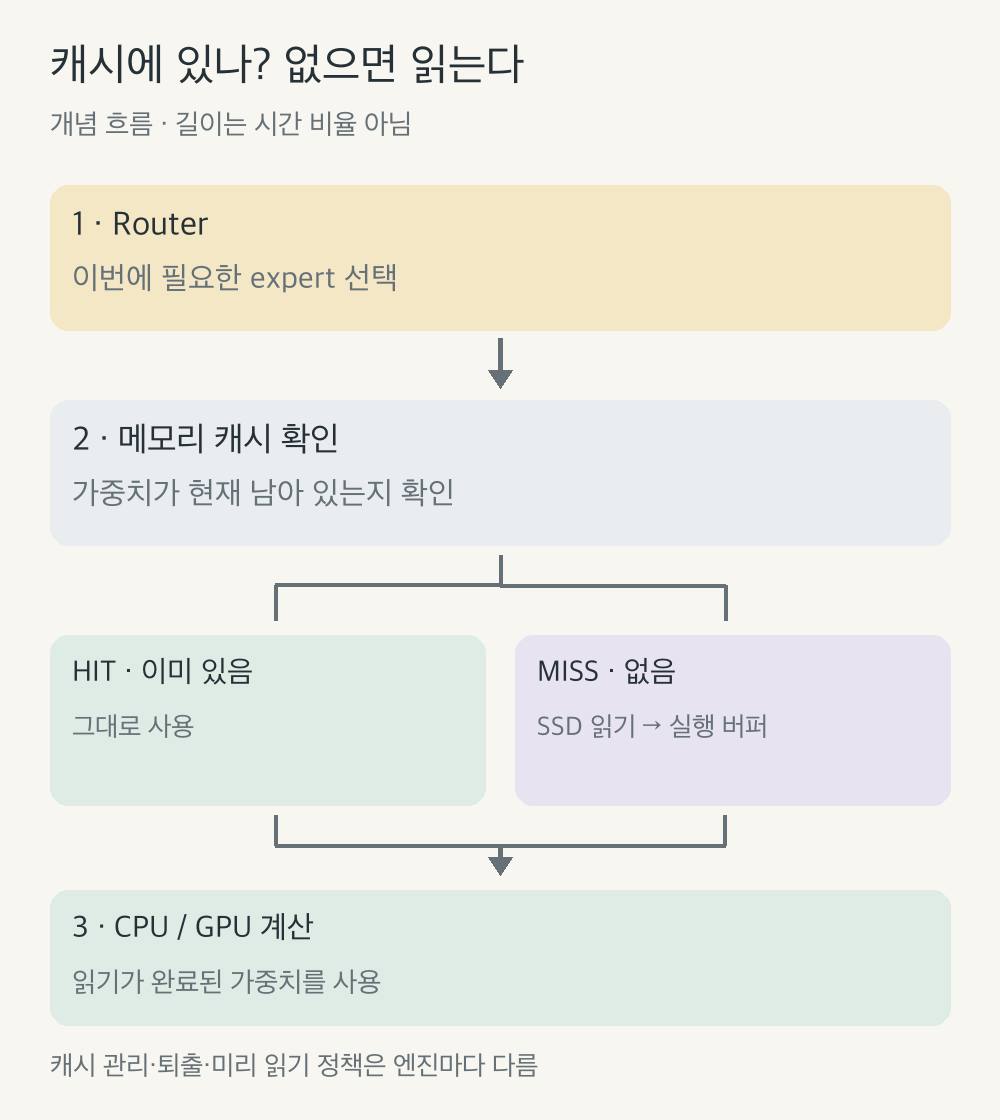
예를 들어 같은 레이어에서 A, B, A를 차례로 요청했다고 해보자. 처음 A와 B는 읽어야 하지만, A가 아직 남아 있다면 세 번째 요청은 다시 읽지 않아도 된다. 반대로 그사이 내보냈다면 또 miss다. 실제 모델 실행 결과가 아닌 캐시 설명용 예시다.
소스에도 이 흐름이 보인다. flash-moe의 실행 코드에는 router의 top-k 선택, 선택한 expert 위치의 pread, 읽기 완료 확인과 Metal 버퍼를 이용하는 경로가 있다. 읽었다고 가정하고 GPU를 먼저 돌리는 건 아니다. 이 경로를 읽어봤다는 것과 내 Mac에서 재현했다는 것은 구분해두려 한다.
SSD 캐시라는 이름으로 묶으면 헷갈린다
SSD를 쓴다는 얘기 안에 서로 다른 데이터가 섞여 있었다.
| 방식 | SSD에 두는 것 | 줄이거나 다시 쓰려는 것 |
|---|---|---|
| Expert weight streaming | 모델의 expert 가중치 | 전체 가중치를 동시에 상주시킬 필요 |
| SSD KV Cache | 과거 입력에서 계산한 K/V 상태 | 같은 prefix를 다시 계산하는 작업 등 |
| 시스템 swap | OS가 내보낸 메모리 페이지 | 시스템 전체의 물리 메모리 압박 |
oMLX의 SSD 계층은 KV Cache 블록을 저장했다가 맞는 prefix 요청에서 복원하는 기능을 설명한다. 이것만으로 큰 모델의 expert 가중치를 SSD에서 스트리밍한다고 볼 수는 없다. 별도로 실험적 MoE Expert Offload와 가중치 읽기 코드도 확인했다. safetensors의 expert를 os.pread로 읽어 상주 슬롯에 넣는 경로지만, 내 모델에서의 실행과 다른 기능과의 조합은 검증 필요다.
mmap도 별개다. Apple의 파일 매핑 문서처럼 파일을 가상 주소 공간에 매핑해 접근하면 필요한 페이지를 커널이 가져올 수 있다. 하지만 매핑했다는 사실만으로 expert별 상주 예산이나 읽기 순서가 정해지는 건 아니다. 스트리밍 구현이 mmap이나 OS 파일 캐시를 활용할 수는 있어도, 둘을 같은 기능으로 부르지는 않겠다.
메모리는 줄여도, 기다림은 남는다
SSD 사양표의 최대 읽기 속도보다, 필요한 가중치를 얼마나 자주 읽고 얼마나 기다리는지가 궁금하다.
Cache hit가 많으면 반복 읽기를 줄일 수 있다. 그래도 expert마다 크기가 다를 수 있고, 같은 hit 비율이어도 읽은 바이트와 기다린 시간이 같지는 않다. OS 파일 캐시에서 돌아온 읽기와 실제 장치 읽기도 나눠 봐야겠다.
SSD 성능을 설명한 SNIA 자료를 보면 I/O 크기와 패턴부터 나눠 봐야 한다. 큰 파일의 최대 순차 읽기 대역폭과 작은 랜덤 읽기 성능은 다르다. Expert도 저장 형식, 읽기 단위, 정렬, 요청 병합에 따라 실제 I/O가 달라질 수 있다.
Queue Depth는 아직 완료되지 않은 요청 수다. 여러 요청을 함께 처리해 처리량을 높일 여지는 있지만 큐와 지연의 관계는 작업에 따라 달라진다. 엔진이 읽기를 미리 발행할 수 있는지, 필요한 expert가 준비될 때까지 GPU가 기다리는지가 궁금하다. QD만 높였다고 토큰 생성까지 빨라지는 건 아니다.
같은 expert를 곧 다시 쓰는 시간적 지역성, 필요한 가중치가 파일에서 가까이 놓인 공간적 지역성도 캐시에 영향을 줄 수 있다. Predictive read-ahead, 즉 prefetch가 맞으면 대기를 숨길 가능성이 있지만 틀리면 불필요한 I/O와 캐시 오염이 생긴다. 실제 routing은 그대로 두고 읽기만 예측하는 방식과, 선택할 expert 자체를 바꾸는 근사 방식도 구분하려 한다. 후자는 출력 품질까지 확인할 문제다.
Hermes의 여러 작업이 같은 모델을 공유하면 접근 패턴도 달라질 것이다. 쓰는 expert 집합이 넓어져 캐시가 빡빡해질 수도 있고 요청끼리 같은 expert를 재사용할 수도 있다. 동시 요청 수와 캐시 성능의 관계는 직접 봐야겠다.
SSD Expert Streaming 비용 계산기
설명용 시뮬레이션 · 기본값은 실제 모델이나 SSD의 측정값이 아니다. 실제 LLM의 tok/s를 예측하는 계산기가 아니다.
- 총 읽기량
- MiB
- 데이터 전송 비용
- ms
- 고정 지연 비용
- ms
- 단순화한 SSD 읽기 비용
- ms
데이터 전송 비용 고정 지연 비용
막대는 두 비용의 비율이다. 서로 다른 입력의 총시간을 같은 척도로 비교하는 그래프는 아니다.
계산식과 가정
read_MiB = expert_size_MiB × cache_misses
read_time_ms = (read_MiB / effective_bandwidth_MiB_s) × 1000
             + cache_misses × fixed_latency_ms
read_bytes로 계산하려면 MiB에 2²⁰을 곱하고 대역폭도 bytes/s로 바꿔야 한다. 여기서는 두 값의 단위를 MiB로 맞췄다.
- 각 캐시 미스는 지정 크기의 실제 장치 읽기 요청 하나를 발생시킨다.
- 읽기끼리, 읽기와 GPU 계산 사이에 중첩이 없다.
- OS 파일 캐시 적중과 Prefetch 효과는 고려하지 않는다.
- 압축 해제·변환·버퍼 할당·GPU 동기화 비용은 포함하지 않는다.
- 유효 대역폭은 주어진 I/O 패턴에서 달성 가능한 전송률이며, 별도 고정 지연은 그 전송 시간에 포함되지 않은 요청당 비용으로 더한다.
실제 시스템은 요청 병렬성·I/O 크기·Queue Depth·OS 파일 캐시·Expert locality·Prefetch·GPU 계산과의 중첩에 따라 달라진다. 계산값은 순차·비중첩 읽기의 단순 비용이며, 예상 추론 지연이나 실제 토큰당 지연이 아니다.
Expert 크기와 miss 수를 바꿔보면 한 번의 읽기가 작아도 합계는 커질 수 있다는 게 보인다. 계산기의 고정 지연은 전송 시간에 포함되지 않은 비용으로 잡았다. 실측한 유효 대역폭이 이미 요청 전체 지연을 포함한다면 여기에 다시 더해 이중으로 셀 수도 있다. 숫자를 대입하기 전에 무엇을 측정했는지부터 확인해야겠다.
양자화하면 읽을 가중치 바이트를 줄일 수 있지만 형식에 맞는 커널과 해제 비용이 따라온다. 읽기·복사·양자화 해제·GPU 계산이 항상 깔끔하게 겹쳐 실행된다고 가정하지는 않으려 한다.
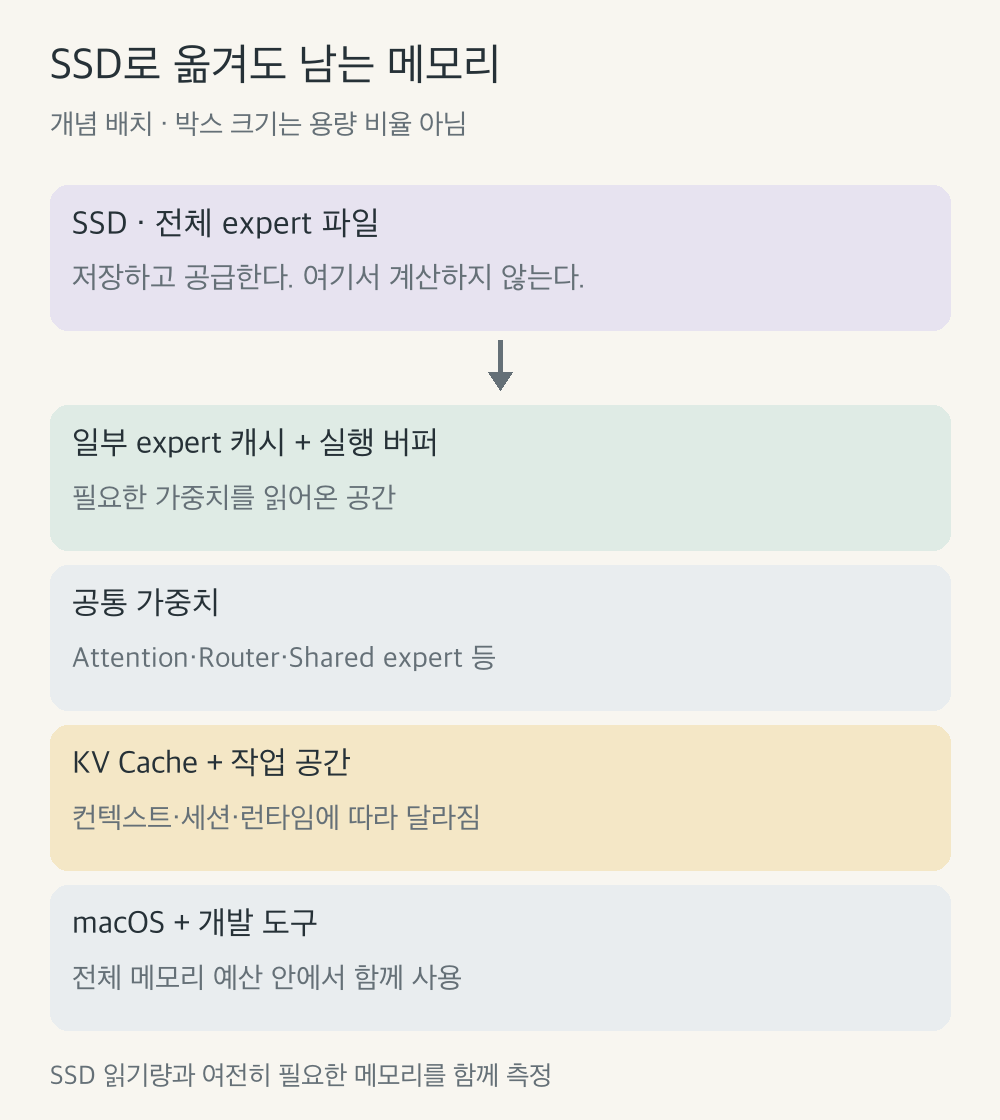
결국 expert 캐시도 EP02의 메모리 예산 안에 들어간다. 컨텍스트와 세션을 늘리면 KV Cache 등이 더 필요하고, 공통 가중치와 실행 공간도 사라지지 않는다. “SSD에 뒀으니 메모리 걱정 끝”은 아니었다.
Mac에서 어떤 구현을 볼까
기존 조사는 2026년 10월 9일, 추가 소스 확인은 10월 10일에 했다. 설치 성공 목록은 아니며 링크는 조사한 버전에 고정했다. 제작자가 공개한 성능을 내 장비의 예상 속도로 가져오지는 않았다.
| 후보 | 확인한 범위 | 남은 확인 |
|---|---|---|
| ds4 | 제한된 expert 캐시·GGUF 읽기, DeepSeek·GLM의 Metal 스트리밍을 문서화 | 정확한 모델·텐서 형식·실효 캐시 예산과 실행 조합 |
| Slipstream | Apple Silicon C++·Metal 엔진, SSD expert streaming·read-ahead를 문서화 | 선택한 체크포인트의 loader·검증·캐시 경로와 실제 실행은 미확인 |
| flash-moe | 특정 모델용 Metal 엔진, expert 선택 뒤 파일 읽기 경로를 소스에서 확인 | 내 장비에서의 재현, 변환 파일과 양자화 조건 |
| Strata-macOS | 작은 GGUF의 Metal 실행 경로 | 조사한 README는 원본 expert streaming·MTP가 Metal에 연결되지 않았다고 명시 |
ds4 문서는 expert 캐시 외의 가중치와 컨텍스트 공간도 필요하다고 설명한다. 그리고 외부 DSpark 조합은 main model이 상주해야 하며 SSD streaming과 지원되지 않는다고 적혀 있다. EP03의 최적화를 여기에 전부 더해서 켤 수는 없겠다. 다른 MTP 경로까지 같은 제한이라고 일반화하지는 않는다.
4비트 스트리밍과 3비트 상주, 어느 쪽이 나을까
같은 큰 모델이라도 4비트 가중치를 SSD에서 가져오는 편이 나을까, 3비트로 줄여 메모리에 전부 올리는 편이 나을까? GPTQ 연구처럼 낮은 비트에서도 품질을 유지하려는 방법은 있지만, 비트 수만 보고 내 작업의 품질 손실을 정할 수는 없다. 실제 파일에는 scale 등 부가 데이터와 혼합 정밀도도 들어갈 수 있어 전체 크기도 확인해야 한다.
| 볼 것 | 4비트 streaming | 3비트 resident |
|---|---|---|
| 품질·전체 가중치 크기 | 양자화 형식과 실제 파일·평가 결과 확인 | 더 작은 파일이 가능하지만 품질 손실과 부가 데이터 확인 |
| 데이터 공급·메모리 여유 | SSD I/O와 Expert Cache 예산, 남는 공간 | 상주 가중치의 메모리 대역폭, 줄어든 가중치가 남기는 여유 |
| Decode·TTFT | 읽기 대기·로드·커널까지 포함해 측정 | 로드·메모리 읽기·커널까지 포함해 측정 |
| 긴 컨텍스트·동시 요청 | KV Cache와 expert 재사용·캐시 압박 | KV Cache와 작업 공간까지 충분히 들어가는지 |
양자화 형식, 런타임, 커널이 다르면 같은 모델 계열이어도 차이를 I/O나 비트 수 하나로 설명하기 어렵다. 어느 쪽이 낫다는 결론은 미뤄두고, 고정 과제의 품질과 기다린 시간을 같이 비교해보려 한다.
도착하면, 들어가는 모델부터 비교하기
Mac Studio M5 Max / 128GB 통합메모리 / 1TB SSD가 오면 우선 메모리에 들어가는 지원 모델부터 시작할 생각이다. 큰 모델의 상주 실행이 불가능하면 그대로 ‘실행 불가’라고 적겠다. 없는 기준 속도로 몇 배 느리다고 계산할 수는 없으니까.
| 실험 | 비교 조건 |
|---|---|
| A · Resident vs Streaming | 가능한 경우 같은 모델·양자화·프롬프트로 전체 상주와 스트리밍 비교. 모델·런타임이 다르면 명시 |
| B · Expert Cache Sweep | 16GB → 24GB → 32GB → 40GB → 48GB는 예시. 엔진이 지원하고 필수 공간이 남는 범위에서만 변경 |
| C · Quantization Trade-off | 같은 모델의 4-bit streaming과 3-bit resident 지원 여부부터 확인. 같은 평가 데이터셋으로 품질·속도 비교가 가능할지 검토 |
| D · Internal vs External SSD | 내장 SSD와 Samsung T7에서 같은 파일·캐시 크기·프롬프트·런타임으로 비교. Thunderbolt NVMe나 Samsung T9은 도입하면 추가 |
| 기록할 것 | 현재 상태 |
|---|---|
| 모델 로드 시간·TTFT·Prefill·Decode tok/s·전체 응답시간 | 도착 후 실측 예정 |
| Peak Memory·메모리 압박·Swap | 도착 후 실측 예정 |
| SSD read bytes·I/O latency·Expert Cache hit/miss | 계측 가능 범위를 확인한 뒤 실측 |
| 요청 바이트·물리 장치 읽기량·복사·양자화 해제·GPU 구간 | 런타임이 노출하는 범위만 측정 |
| 출력 토큰 수·종료 이유·고정 과제의 정답 | 조건과 함께 기록 예정 |
모델 파일·양자화·런타임 버전·프롬프트·입출력 토큰 수·sampling·컨텍스트·batch를 고정하고, 캐시 예산이나 저장 장치 중 하나씩 바꿀 생각이다. 동일하게 맞출 수 없는 조건은 결과 옆에 남겨두겠다. 대역폭은 해당 읽기 패턴에서 따로 측정하고, OS 파일 캐시 상태와 드라이브·연결 인터페이스·파일 시스템·열 상태도 기록한다.
Cold와 warm은 나눠 보되, 프로세스를 다시 켰다고 OS 파일 캐시까지 비었다고 부르지는 않겠다. 지금 8GB iMac에서 1TB 외장 SSD로 저장 공간을 버티며 시뮬레이터를 쓰기 불편했던 경험만으로 스트리밍 성능까지 알 수는 없다. EP01에서 나눈 Prefill·Decode와 전체 응답시간을 따로 봐야겠다.
아직 모르는 것
내가 쓰려는 큰 모델에서 캐시가 얼마나 잘 맞을지, 읽기 대기가 어느 정도일지는 아직 모른다. 1TB 내부 SSD에도 모델 원본과 변환본, 개발 파일을 같이 두면 저장 공간 예산부터 다시 봐야 한다.
이 방식이 궁금한 이유는 큰 모델을 무조건 상주시켜두려는 게 아니다. 평소에는 중형 LLM과 작은 판단 모델을 쓰고, 필요할 때만 더 큰 모델을 불러오는 운영이 가능할지 보고 싶어서다. 실행된다는 것과 답을 기다릴 만하다는 것은 끝까지 따로 봐야겠다.
SSD를 활용해 메모리 한계를 넘는 것과, 처음부터 충분한 GPU 메모리를 구매하는 것 중 어느 쪽이 더 경제적일까? 다음 **EP05 — Mac Studio vs NVIDIA GPU: 같은 예산으로 개인 AI 워크스테이션을 만든다면?**에서는 GPU 단품이 아니라 완성된 시스템 가격, 메모리 용량·대역폭·성능·전력·확장성을 함께 비교해보려 한다. 아직 실측 전이라 어느 쪽이 더 낫다고 정해두지는 않았다.
댓글과 좋아요
로그인 없이 닉네임으로 남길 수 있어. 닉네임과 댓글은 공개되고, 댓글은 확인 후 올라가.