Mac에서 로컬 LLM 최적화하기 / EP05
860만 원짜리 Mac Studio 대신 RTX 5090 PC를 샀다면?
Mac Studio M5 Max 128GB에 약 860만 원을 썼다. RTX 5090 PC와 DGX Spark를 돌아보며, LLM 속도보다 앱 개발 환경을 함께 바꾸고 싶었던 이유를 정리했다.
이 글의 내용
860만 원, RTX PC를 샀어야 했을까?
Mac Studio M5 Max 128GB / 1TB를 주문했다. 교육할인을 받을 수 있는 경로가 있어 AppleCare까지 약 860만 원. AppleCare는 약 20만 원이고, 할인 없이 같은 조건이면 약 940만 원이었다.
결제하고 나니 다른 선택지가 궁금해졌다. 이 돈으로 RTX GPU PC를 만들었다면 로컬 AI는 더 빨랐을까? 큰 모델도 돌리고, 이미지와 영상도 만들고 싶은데. 잘 산 걸까…?
다만 내가 바꾸고 싶은 건 LLM 서버만이 아니다. 여러 앱을 개발하면서 Xcode와 Simulator를 쓰고, 옆에서는 Hermes와 로컬 모델을 돌릴 환경이다. 그래서 속도뿐 아니라 무엇을 담을 수 있고, 어떤 일을 한 컴퓨터에서 할 수 있는지 같이 살펴봤다.
같은 돈으로 어떤 시스템을 구성할 수 있을까?
GPU 단품과 Mac 한 대를 비교하면 시작부터 조건이 다르다. PC에는 CPU·RAM·SSD·전원·냉각도 필요하다. 앞서 조사한 GPU 제외 부품 약 279만 원에 카드를 더한 예시는 아래와 같다. 부품명을 길게 나열하는 대신, 확인한 금액과 그 금액의 성격만 남겼다.
| 구성 | 확인한 금액 | 이 숫자를 읽는 방법 |
|---|---|---|
| 내 Mac Studio M5 Max 128GB / 1TB | 약 860만 원 | 실제 결제액의 대략값 · 교육할인 + AppleCare |
| RTX 5090 32GB PC · 시스템 RAM 64GB / SSD 1TB | 약 1,138만 원 | 신품 부품 합계 예시 · 최종 구매 견적 미확인 |
| 같은 PC, 다른 5090 카드 가격 적용 | 약 708만 원 | 품절 GPU 가격 기반 가상 합계 · 구매 가능한 견적 아님 |
| RTX 5080 16GB PC | 약 537만 원 | 신품 부품 합계 예시 · 최종 견적 미확인 |
| RTX 3090 24GB PC | 약 384만 원 | 중고 GPU 호가 + 나머지 신품 부품 · 거래·보증 미확인 |
| DGX Spark 128GB / 4TB | 국내 표시 약 1,035만 원 / 해외직구 표시 약 899만 원 | 재고·최종 구매가 미확인 · 해외직구는 관세·부가세 별도 |
가격 기록일은 2026-10-10이다. PC 예시는 Linux·직접 조립 기준이며 유료 OS·조립·배송비를 포함한 확정 견적이 아니다. Spark는 4TB이고 내 Mac은 1TB에 AppleCare 포함이라 같은 조건의 가격표도 아니다. 출처는 글 끝에 모았다.
처음 봤던 1,600만 원대 고급 5090 완제품이 일반적인 PC 가격을 대표하지는 않는다. 그렇다고 품절 카드 가격으로 “860만 원 안에 충분하다”고 할 수도 없다. 같은 예산의 구매 가능한 5090 완성 견적은 아직 확보하지 못했다. 대신 5080이나 중고 3090처럼 예산을 덜 쓰는 방향도 있다. 필요한 모델이 그 VRAM 안에 들어가는지가 다음 질문이다.
128GB 통합메모리 vs 32GB VRAM
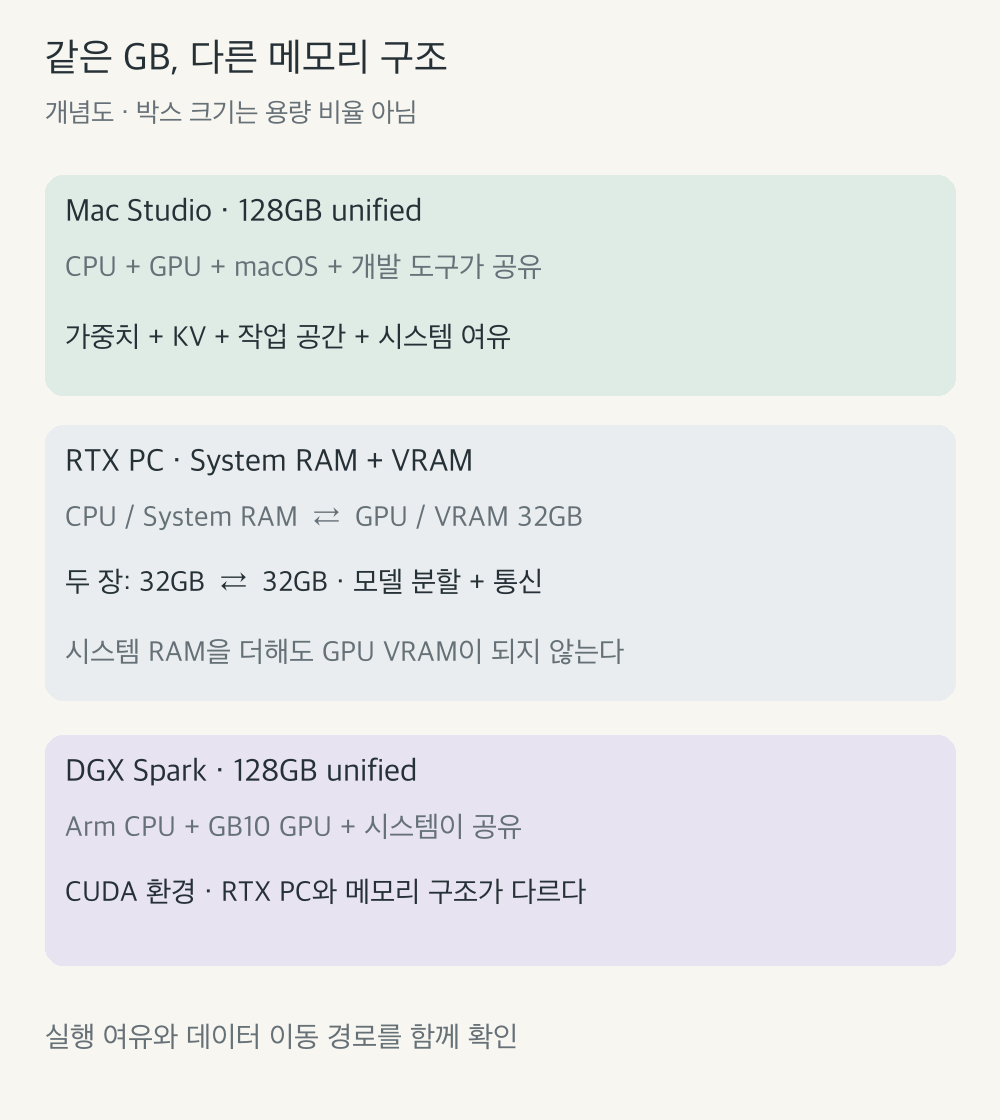
Mac과 Spark는 CPU·GPU가 128GB를 공유한다. RTX 5090은 전용 VRAM 32GB에 시스템 RAM이 따로 있다. PC에 RAM을 더 꽂는다고 GPU VRAM이 늘어나는 건 아니다.
용량은 담을 공간, 대역폭은 데이터를 옮기는 속도다. 두 숫자를 분리해서 보면 Spark가 왜 흥미롭고, 5090이 왜 빠른 작은 모델용 후보인지 이해하기 쉽다.
| 제조사 사양 | 메모리 구조 | 메모리 대역폭 (GB/s) |
|---|---|---|
| Mac Studio M5 Max · 40코어 GPU | 128GB 통합메모리 구성 | 614 |
| RTX 5090 | 32GB 전용 VRAM | 1,792 |
| DGX Spark | 128GB 공유 시스템 메모리 | 273 |
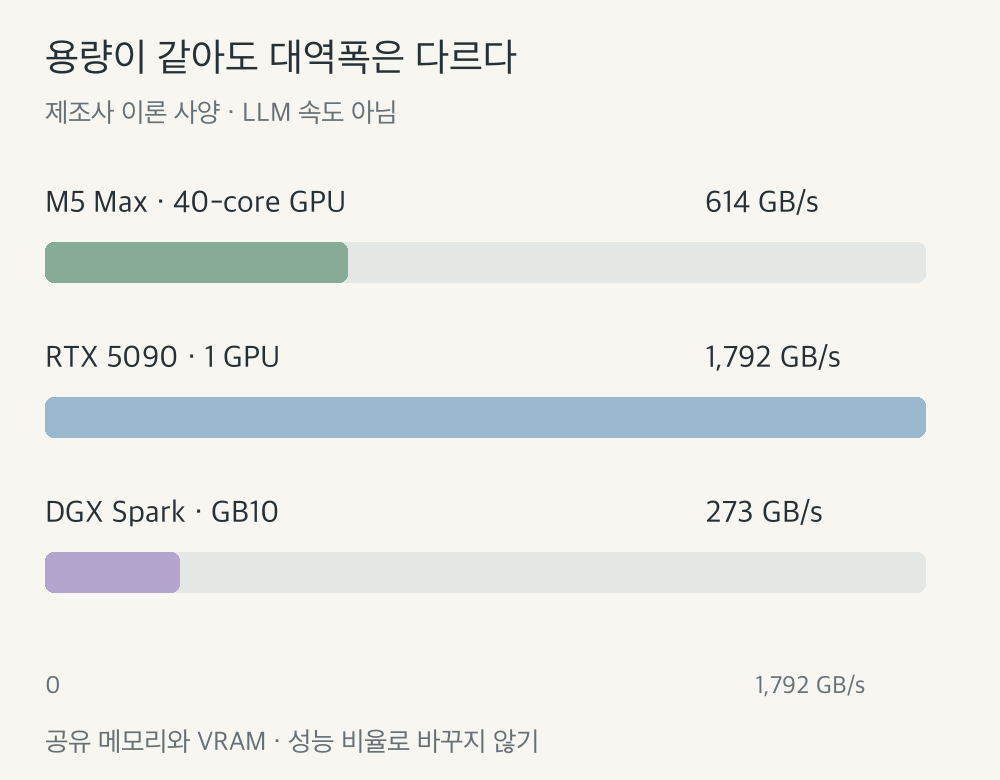
작은 배치의 Decode에서는 가중치를 반복해 읽는 비용이 중요해질 수 있다. 하지만 이 대역폭 비율이 그대로 토큰 속도 비율이 되지는 않는다. 모델 구조와 커널, 캐시, 연산 성능도 함께 작용한다. EP01에서 본 Prefill과 Decode의 차이가 여기서 다시 나온다.
그럼 내가 올려보고 싶은 모델은 어디까지 들어갈까?
| 모델·작업 | Mac Studio 128GB | RTX 5090 32GB PC | DGX Spark 128GB |
|---|---|---|---|
| 20–30B Q4 LLM | 메모리상 적재 가능성 높음 · 개발 도구와 합산 | 메모리상 적재 가능성 높음 · 긴 컨텍스트는 여유 확인 | 메모리상 적재 가능성 높음 · 런타임 확인 |
| 가중치만 70–100GB | OS·KV·버퍼까지 들어가는지 확인 | 단일 VRAM에는 초과 · 오프로딩/분할과 충분한 시스템 RAM 필요 | OS·KV·버퍼까지 확인 · Arm 런타임 확인 |
| 대형 MoE | 전체 expert 가중치 크기가 적재 기준 | 활성 파라미터가 작아도 전체 가중치는 VRAM 초과 가능 | 전체 가중치와 런타임 지원 확인 |
| 긴 컨텍스트·여러 세션 | 공유 공간의 KV·작업 메모리 압박 | VRAM의 KV·버퍼 압박 | 공유 공간의 KV·작업 메모리 압박 |
20–30B를 4비트로 계산하면 가중치 비트 수만 약 10–15GB다. 실제 파일에는 양자화 메타데이터 등이 더해지고, 실행할 때 KV Cache와 버퍼도 필요하다. 이 계산은 특정 모델의 실사용량이 아니다. EP02의 메모리 예산처럼 전체를 합산해야 한다. 적재 가능성과 쓸 만한 속도도 별개다.
MoE의 활성 파라미터가 작다는 말은 모든 expert를 적은 메모리에 담는다는 뜻이 아니다. 5090 두 장도 VRAM 합계 64GB가 자동으로 하나의 연속된 공간이 되지는 않는다. NVLink 없이 지원되는 런타임으로 분할하고 통신해야 한다. 더 큰 모델을 EP04의 SSD expert streaming으로 다룬다면, 적재 공간 대신 SSD 읽기 비용을 함께 검토하게 된다.
실제로 얼마나 빠를까? — Prefill과 Decode
용량표만으로는 기다리는 시간을 알 수 없다. 그래서 이전에 찾아본 llama.cpp 공개 결과를 다시 가져왔다. 입력 512토큰을 처리하는 pp512, 128토큰을 생성하는 tg128을 나눠 읽으면 된다.
공개 LLM 벤치마크 · 작은 모델의 두 단계
Llama 2 7B Q4_0 · GPU offload 99. 커뮤니티의 독립 제출값으로 호스트·드라이버·런타임·파일 해시·전력 조건을 맞춘 통제 비교가 아니다. NVIDIA는 CUDA / Flash Attention 꺼짐, Mac은 Metal / FA 설정 미확인. pp512는 입력 512토큰, tg128은 생성 128토큰 테스트다. 각 축은 0부터 시작하며 서로 다른 범위다.
이 그래프는 작은 모델이 메모리에 들어간 경우의 속도 참고값이다. 전체 시스템 가격·대형 모델 적재·Xcode·전기비를 포함한 가성비 순위가 아니다.
Prefill · pp512
0 — 15,000 tokens/s
- RTX 509014,073.41
- RTX 409011,992.70
- RTX 50808,297.36
- RTX 30905,174.69
- RTX A60004,913.93
- M5 Max · MacBook Pro3,347.44
- DGX Spark · 128GB3,062.31
Decode · tg128
0 — 300 tokens/s
- RTX 5090290.02
- RTX 4090186.21
- RTX 5080181.99
- RTX 3090158.16
- RTX A6000138.73
- M5 Max · MacBook Pro119.08
- DGX Spark · 128GB57.21
Mac은 16인치 MacBook Pro의 M5 Max / 40코어 GPU / 128GB 제출값이다(2026-06-22). 주문한 Mac Studio의 결과가 아니다. 냉각·전력·런타임·모델 파일 해시를 맞추지 않았으므로 같은 칩이라는 이유로 Studio 속도를 확정하지 않는다.
| 측정 장비 / 백엔드 | Prefill pp512 tok/s | Decode tg128 tok/s | llama.cpp 버전 · 출처 |
|---|---|---|---|
| RTX 5090 CUDA · FA off | 14073.41 ± 115.16 | 290.02 ± 1.10 | 8cf6b42@totaldev |
| RTX 4090 CUDA · FA off | 11992.70 ± 107.99 | 186.21 ± 0.13 | 2241453@lhl |
| RTX 5080 CUDA · FA off | 8297.36 ± 9.50 | 181.99 ± 0.42 | 8a4280c@Hedede |
| RTX 3090 CUDA · FA off | 5174.69 ± 21.83 | 158.16 ± 0.21 | c76b420@m18coppola |
| RTX A6000 CUDA · FA off | 4913.93 ± 6.79 | 138.73 ± 2.75 | 4795c91@Hedede |
| M5 Max · MacBook Pro 16″ · 40 GPU cores · 128GB · Metal/BLAS · 6 threads · FA ? | 3347.44 ± 1.53 | 119.08 ± 0.69 | 52b3df0@michaelasper |
| DGX Spark · 128GB CUDA · FA off | 3062.31 ± 11.02 | 57.21 ± 0.06 | 5acd455@ggerganov |
출처와 런타임 버전
llama.cpp · CUDA scoreboard (no FA) · 2026-10-10
llama.cpp · Apple Silicon · @michaelasper · 2026-06-22 · 확인 2026-10-10
- RTX 5090 ·
8cf6b42· @totaldev - RTX 4090 ·
2241453· @lhl - RTX 5080 ·
8a4280c· @Hedede - RTX 3090 ·
c76b420· @m18coppola - RTX A6000 ·
4795c91· @Hedede - M5 Max · MacBook Pro ·
52b3df0· @michaelasper - DGX Spark · 128GB ·
5acd455· @ggerganov
원문은 최신 최적화 또는 높은 결과를 골라 싣는 표라 선택 편향도 있다. 이 A6000은 Ampere 제품이다.
작은 모델이 메모리에 들어간 이 결과에서는 RTX 5090의 처리량이 눈에 띈다. 4090·5080·3090도 함께 보면 꼭 가장 비싼 카드만 볼 필요는 없겠다. 반면 Spark는 128GB를 갖췄지만 작은 모델의 Decode가 용량만큼 빨라지지는 않는다. 큰 모델을 담는 능력과 작은 모델을 빨리 돌리는 능력이 다른 셈이다.
대형 MoE와 70–100GB 가중치에 대한 세 시스템의 동조건 자료도 확보하지 못했으므로 빈칸을 예상 속도로 채우지는 않았다.
긴 입력의 Prefill, 답변 생성의 Decode, 첫 토큰까지의 TTFT도 서로 다르다. EP03의 가속을 켜면 검증 비용과 채택 길이에 따라 결과가 다시 달라진다. 장비가 오면 내가 쓰는 모델로 짧은 답변과 긴 답변부터 비교해보고 싶다.
내 작업에 어떤 시스템이 적합할까?
내가 만들고 있는 건 Cookly·KnitLens·Delsa·소복·소리여행이다. 지금 M1 iMac 8GB / 256GB에서 IDE와 Xcode, Simulator를 오가면 메모리와 저장 공간이 빠듯해진다. Samsung T7 1TB로 버티지만 시뮬레이터까지 외장에 두니 느려서 불편했다. EP00의 고민은 여기서 시작됐다.
RTX PC나 Spark에 AI를 맡길 수는 있다. 하지만 Xcode와 Simulator가 도는 곳은 여전히 Mac이다. GPU 서버를 사도 8GB iMac의 개발 환경까지 좋아지지는 않는다. Windows/Linux PC나 Spark로 Xcode를 직접 대체할 수 없으니, 비교는 Mac Studio 한 대와 개발 Mac + AI 서버 사이가 된다.
이미지·영상 생성과 LoRA가 중심이면 CUDA 쪽이 매력적이다. ComfyUI는 Apple Silicon도 지원하지만 원하는 모델·커스텀 노드·학습 백엔드까지 되는지는 따로 확인해야 한다. Spark 역시 CUDA와 큰 공유 메모리를 갖췄다는 이유로 모든 RTX workflow가 Arm Linux에서 그대로 되는 것은 아니다.
내 계획은 Hermes와 중형 LLM을 자주 쓰다가 필요할 때 큰 모델이나 Vision·음성·이미지 모델로 바꾸는 것이다. 전부 동시에 올릴 생각은 없다. 예산·용도·모델 크기를 바꿔보면 어디서 제약이 생기는지 정리할 수 있다.
내 작업이라면 무엇부터 볼까?
용도별 검토 도구 · 성능 예측이나 구매 추천 순위가 아니다. 가격 확인일 2026-10-10. 품절·미확인 견적은 구매 가능한 후보로 표시하지 않는다.
- 검토할 구성 방향
- Mac Studio와 Mac + 별도 GPU 서버 비교
- 장점
- Mac은 Xcode와 로컬 AI를 같은 개발 환경에서 다룰 수 있다.
- 제약
- CUDA 전용 작업은 별도 환경이 필요할 수 있다. PC만으로 Xcode를 대체하지 못한다. 20–30B Q4는 가중치만 약 10–15GB라는 비트 수 계산이 출발점이다. 실제 파일·KV·버퍼까지 합산해야 하며 16GB GPU는 특히 여유를 확인한다.
- 추가 확인
- 개발 도구와 상주 모델의 메모리, 기존 Mac 상태, 두 장비 운영비를 확인한다.
- 가격·재고 확인 상태
- 내 Mac 약 860만 원, 신품 5080 부품 예시 약 537만 원, 개봉·미사용 4090 예시 약 918만 원. Spark 해외직구 표시가 899만 원은 관세·부가세 별도이며 최종 구매가 미확인. 모두 자격·재고·최종 견적 확인 필요. 품절 GPU를 쓴 708만 원대 5090은 구매 가능 후보에서 제외했다.
이 도구는 구매 가능한 완제품을 자동으로 골라주는 견적기가 아니다. 나는 개발 환경과 큰 메모리의 조합을 먼저 보고, CUDA 작업이 중요해지면 Mac + 별도 GPU 서버 쪽을 다시 비교하려 한다. OpenCode Go와 Codex도 계속 병행할 생각이라 로컬 모델 하나에 모든 예산을 걸 필요는 없겠다.
그래서 나는 Mac Studio를 선택했다
가장 빠른 LLM 머신이라고 확인해서 산 건 아니다. 앱 개발 환경을 바꾸면서 로컬 AI를 실험할 큰 메모리도 함께 확보하고 싶었다. 지금 8GB iMac에서 자주 끊기는 두 일을 한 번에 풀어보려는 선택이다.
CUDA 전용 영상 workflow나 KnitLens 학습이 Mac에서 막히면 NVIDIA 서버나 클라우드가 더 나을 수 있다. 반대로 개발 도구를 켜둔 채 에이전트와 모델을 쓰고, 가끔 큰 모델을 올리는 일에는 macOS와 넓은 공유 공간을 함께 갖는 쪽에 마음이 간다. Spark도 큰 모델용 서버 후보지만 개발 Mac을 따로 유지해야 하는 조건은 남는다.
상시 켜둘 Hermes의 대기 전력과 작업 완료까지 쓴 에너지도 궁금하다. GPU TGP나 전원 어댑터 용량을 시스템 전체 전기비로 바꾸지는 않으려 한다. 실제 소비전력과 사용 시간을 알아야 운영비까지 비교할 수 있다.
860만 원을 잘 쓴 건지는 개발 중 기다림, 모델 전환, 원하는 이미지·영상 작업까지 직접 써보고 판단하려 한다. 도착하면 “860만 원짜리 선택은 옳았을까?”라는 글로 돌아오겠다.
일단 장비가 와야 한다.
참고 자료
확인일: 2026-10-10. Mac 가격은 실제 결제액의 대략값이다. 아래 판매가는 관찰한 특정 구성의 표시값이며 시장 최저·평균이나 확정 구매 견적이 아니다.
-
사양·개발 환경: Apple Mac Studio, RTX 5090, DGX Spark, Xcode 지원 환경.
-
공개 성능·실행 경로: llama.cpp CUDA 제출값, Apple Silicon 제출값, ComfyUI, MLX, Spark Arm 이식 가이드, 멀티 GPU 추론.
-
가격 근거: 5090 카드, 품절 카드의 조건부 예시, 특정 고급 완제품, 5080 카드, 3090 중고 호가, Spark 국내 표시가, Spark 해외직구 표시가. PC 합계는 당시 확인한 GPU 제외 부품 약 279만 원을 더한 예시다.
-
메모리 대역폭: Apple 공식 Studio 사양, NVIDIA Blackwell 아키텍처 문서, DGX Spark 공식 사양. 확인일: 2026-10-10.
댓글과 좋아요
로그인 없이 닉네임으로 남길 수 있어. 닉네임과 댓글은 공개되고, 댓글은 확인 후 올라가.